Пост о том, где в нашей высокоскоростной «12-минутной» аналитике всё ещё нужен человек. Без стыда признаюсь: нужен.
Есть притча-анекдот. Лиса быстрее и умнее зайца, но поймать его не может. Лиса объясняет: «Я просчитываю, куда он прыгнет. А этот идиот сам не знает, куда прыгнет!»😅. Обычно её рассказывают как утешение: ИИ нас не догонит, пока мы умеем вести себя нелогично и непредсказуемо. Я её рассказываю по другому поводу. Лиса здесь алгоритм. А заяц не человек, а ошибка, которая прячется ровно там, где алгоритм излишне уверен в своей непогрешимости.
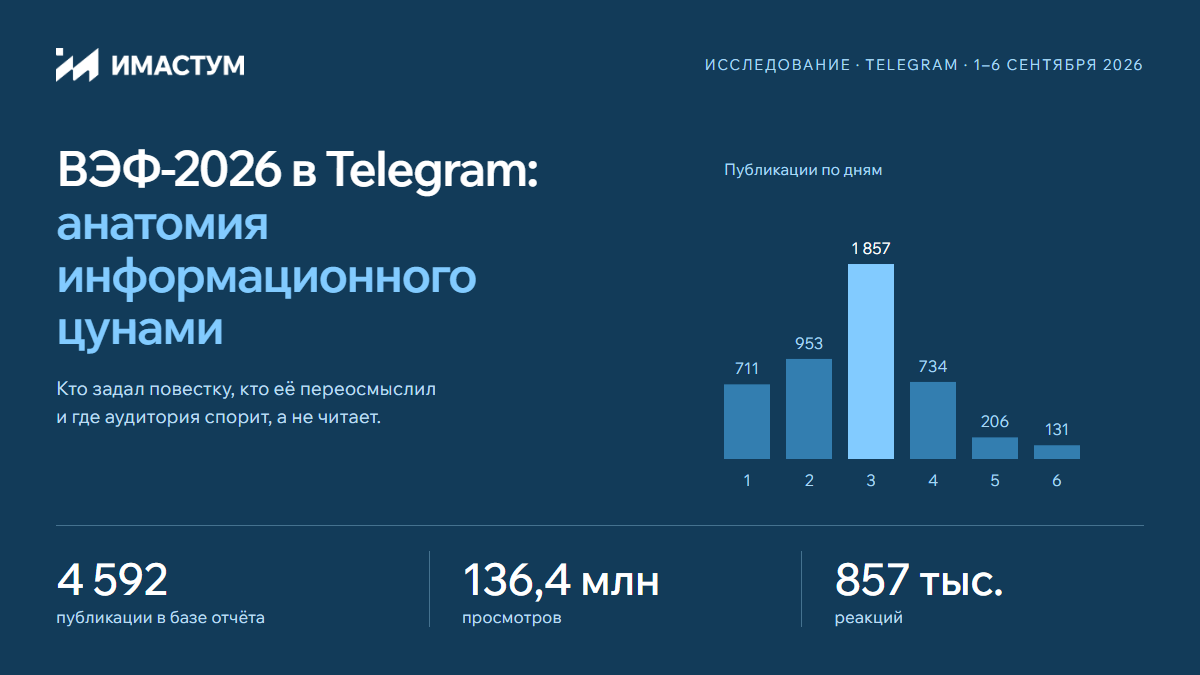
В сентябре ИИ-агенты собрали отчёт по ВЭФ: 5 001 публикация в Telegram, 1 614 каналов, за 12 минут машинного времени. Плюс несколько часов моего. Отдельным проходом они проверили каждый канал на статус иноагента, нежелательной или экстремистской организации, при сомнении убирали из базы. Отсеяли 400 с лишним публикаций.
Потом я сел сверять вручную. И нашёл канал-иноагент, который прошёл через все фильтры. Он в реестре с 2024 года.
Свежая выгрузка из реестра в контексте была, но где-то в его середине. Обычно причина банальна: модель её проскочила (эффект Lost in the Middle) и достроила ответ по памяти, а память у неё неполная и/или устаревшая.
Вот где прятался «заяц». Не в том, что человек хитрее алгоритма и его не просчитать. А в том, что алгоритм ошибается ровно там, где уверен, и сам этого не замечает. Снаружи иноагент выглядел как обычный новостной канал с миллионом подписчиков.
Лечится это не всегда «более умной моделью», а архитектурой. К примеру, каждую проверку по реестру перепроверяет второй, а лучше и n-й агент на других моделях, и расхождения между ними уходят человеку. Перекрёстная проверка помогает, но не гарантирует результат. Ещё лучше: сверку с реестром вообще не стоит отдавать LLM. Это детерминированная задача, точное сопоставление по ID или username (через таблицу соответствий) с выгрузкой реестра, и решается она кодом, ошибки которого воспроизводимы и видны, а не прячутся за уверенным тоном цифрового льстеца.
Кто придумал поставить второго агента или скрипт и на что именно его нацелить? Человек. Пока🤓. Отчёт переделан, канал из базы убран, цифры пересчитаны. Свежая версия по той же ссылке – доступна.
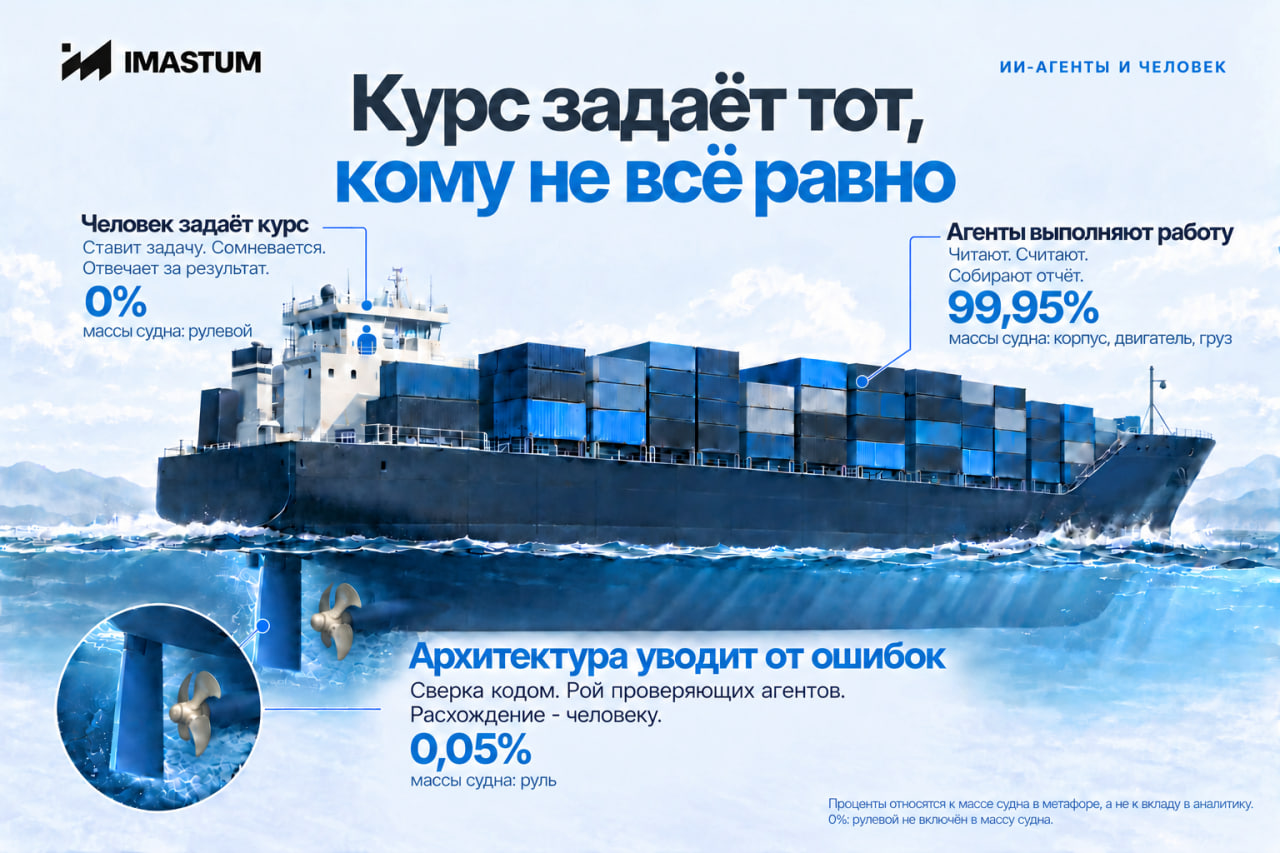
Сколько в этой работе человека? Отвечу через аналогию с кораблём. Руль современного судна весит порядка 0,05% от его массы. Остальные 99,95% – это двигатель, корпус и груз, и всё это работает безупречно: двигатель толкает, корпус держит, трюм полон. Но пройдёт корабль фарватер или сядет на мель, решает не двигатель и не груз. Решают те самые 0,05% – руль. Механизм крошечный, но поворачивает всю махину. А рулевой в массе корабля вообще не учитывается: практически ноль. При этом курс задаёт именно он.
В нашей работе так же. Почти всё делают агенты: читают тысячи текстов, размечают, считают, собирают графики, верстают. Это двигатель, корпус и груз. За 12 минут вместо двух дней работы команды аналитиков. Руль – это архитектура аналитической среды и система проверок: агенты-верификаторы, скрипты сверки с реестром, правило «расхождения уходят человеку» и т.д. Сама по себе эта деталь крошечная, но именно она разворачивает всю аналитику. А рулевой – это человек: задать направление, посмотреть на массив «out of the box», предположить неочевидное там, где данных не хватает, включить воображение, придумать этот самый руль и в конце проверить то, в чём модель слишком уверена (уверенность модели плохо предсказывает её правоту).
Лиса быстрая и умная. А корабль тяжёлый. Так, ладно, с метафорами я перестарался😅
Агенту всё равно, сядет корабль на мель или нет. Это не упрёк, у него просто нет на это причины. Курс задаёт тот, кому не всё равно, куда плыть, и кто готов усомниться в том, что выглядит очевидным. Пока это человек.